Jev 是什麼?System One 模型、應用、開源生態與實測比較
Jev 是指 TypeSafe 推出的 System One 決策模型,接收狀態與封閉問題,回傳 Choice、Score 或 Noul 及機率,而不是自由文字。適合 RAG 路由、客服分流、LLM guardrail、內容審核與風險分級;文字生成、精確計算和多步推理仍應交給程式或生成式模型。導入前應用自有資料評測,並依風險設定覆核門檻。
過去幾年,我們習慣把各種 AI 任務都交給大型語言模型:判斷客服信件該送到哪一組、決定 RAG 要查哪個資料源、檢查模型輸出有沒有違反政策,甚至只是回答一個「是或否」。但這些任務真正需要的,通常不是一段寫得通順的文字,而是一個能讓程式直接採取下一步的決策。
TypeSafe AI 推出的 Jev,就是為這類工作設計的模型。它不和使用者聊天,也不逐字生成答案,而是接收一份狀態與一組有型別的問題,回傳選項、分數或機率。TypeSafe 把這類模型稱為 System One model。
這篇文章會依序說明 Jev 解決了什麼問題、System One 模型和一般 LLM 有何不同、適合放進哪些應用,以及目前的開源生態。最後也會用我們完成的 Jev Benchmark,檢查 Jev 與幾套可自行部署的模型,在多輪 RAG 路由任務上究竟表現如何。
Jev 想解決的痛點:程式需要決策,LLM 卻在生成文字
一般 LLM 的核心工作是預測下一個 token。即使要求它輸出 JSON,底層仍然是在生成字串。對人機對話來說,這是優點;但當輸出是要交給另一段程式使用時,就會出現幾個結構性的問題。
- 輸出還要再解析與驗證。程式需要的是
billing、technical或other,模型卻可能多寫一段解釋、換一個欄位名稱,或回傳不在選項內的答案。Structured Output 能改善格式問題,但使用者仍是在呼叫一個以文字生成為主要目標的模型。 - 簡單決策也要付出生成延遲。分類、路由與 yes/no 判斷通常只需要一個封閉答案。如果仍讓大型模型逐字解釋,系統會把時間與費用花在不會被使用的文字上。
- 「我有 95% 把握」不一定是可用的機率。LLM 在文字中寫出的信心數字,可能只是下一個看起來合理的 token。真正要做自動化,系統需要的是經過評測與校準、能在大量預測上檢驗的機率,而不是語氣上的自信。
- 一個流程往往同時有很多小判斷。例如客服分流不只要判斷部門,還要判斷急迫性、退款意圖、客戶情緒與是否需要人工介入。若逐題呼叫生成式模型,延遲與成本會線性增加。
Jev 的解法不是做一個更會遵守 JSON 格式的聊天模型,而是改變模型與軟體之間的介面:輸入是待判斷的 state,輸出是預先定義好的 typed decision 與機率分布。程式不必從文字中猜結論,可以直接用 if、排序、門檻或規則組合這些答案。
什麼是 System One 模型
System One 這個名稱借用 Daniel Kahneman 在《快思慢想》中普及的 System 1 與 System 2 概念。System 1 代表快速、直覺、聚焦的判斷;System 2 則偏向較慢、需要多步推理的思考。TypeSafe 用這個比喻描述一種面向軟體的 AI:它不追求包辦所有任務,而是快速完成範圍明確的判斷。
依據 TypeSafe 官方說明,Jev 會針對同一份 state 評估多個問題,並回傳有型別的答案與機率。它目前支援三種 primitive:
| Primitive | 適合問什麼 | 主要輸出 |
|---|---|---|
| Choice | 從已知選項中選一個,例如客服案件應由哪個部門處理 | 選中的 key、各選項機率、confidence |
| Score | 依有順序的尺度評分,例如低、中、高風險 | 加權分數、各級機率、confidence |
| Noul | 判斷某個敘述是否成立,例如訊息是否要求退款 | 介於 0 到 1 的成立機率 |
多個問題可以放在同一次 API 請求中,並且各自針對相同 state 平行評估。這代表應用程式可以先把可能用到的判斷一次問完,再由程式決定哪些答案和當前流程有關。官方把這個模式稱為 speculative fan-out。
另一個重要差異是:typed output 只保證答案落在你定義的結構裡,不保證判斷一定正確。Jev 不會憑空發明一個 schema 外的部門名稱,但它仍可能從合法選項中挑錯一個。官方也明確指出,機率校準描述的是一群預測的統計關係,不是對單一答案的保證。因此實務上仍要根據風險設門檻:高信心且低風險的決策可以自動執行;中等信心要求使用者確認;低信心或高風險案件轉交人工或 reasoning model。
一個典型的 Jev 工作流程
以企業 RAG 助理為例,使用者問「請用上個月簽的合約,確認這筆費用能不能報銷」。系統可以把對話紀錄、可用資料源與權限狀態整理成 state,然後同時問:
- 答案應該查指定文件、知識庫、公開網路,還是呼叫工具?
- 這一輪是否延續前一個話題,或已經切換範圍?
- 應該直接回答、分析比較、追問缺少資訊,還是因權限不足而擋下?
- 下一輪是否仍受「只能使用這份合約」的限制?
Jev 回傳的是一組結構化決策,真正的控制流程仍留在程式裡。程式先檢查權限與信心門檻,再決定要不要開文件、執行檢索或請使用者補充資料。等到取得正確證據後,才把需要生成的部分交給 LLM 撰寫。
這是一個很實用的雙軌設計:
- System One lane 負責高頻、封閉、可量測的判斷。
- 程式碼 負責權限、狀態、數學、門檻與副作用。
- 生成式或推理模型 負責需要解釋、寫作、多步推理與開放答案的工作。
- 人工 處理低信心、高風險或無法逆轉的情況。
關鍵不是用 Jev 取代所有 LLM,而是不要再用大型生成模型處理每一個小決策。
Jev 可以用在哪裡
只要答案空間能事先定義,而且結果要交給軟體而不是直接給人閱讀,就可能是 System One 模型的候選場景。Jev 發布後,社群很快把這種模式放進瀏覽器、廣告過濾、交易、搜尋、程式碼審查與智慧家庭。下面先看四個最直觀的例子。
案例一:即時廣告篩選,把「這是不是廣告」交給 Jev
TypeSafe AdBlock 是一個 MIT 授權的 Chrome Manifest V3 擴充功能。程式先用 DOM 規則找出像廣告的候選元素,再把標籤、class、文字摘要、連結網域與版位形狀整理成小型 JSON;Jev 用 Noul 回答每個候選元素是付費廣告的機率。預設 P(ad) ≥ 0.70 時,程式才把元素移除。
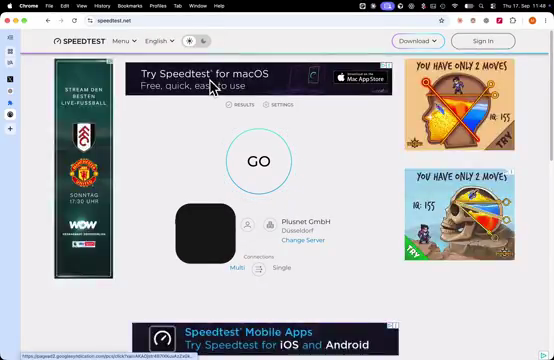
過濾前:頁面四周仍有廣告版位。
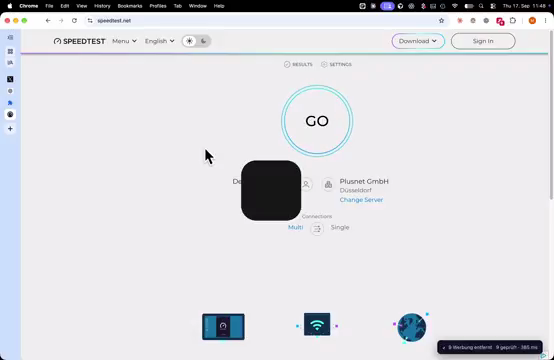
過濾後:被判定為廣告的 DOM 元素已移除。
圖:作者 Zachi 的原始示範影片畫面。
這個案例很能說明 System One 的分工:候選元素搜尋、批次上限、門檻、動畫與刪除都由程式控制,Jev 只做語意判斷。作者也明確提醒,這是展示模型能力的實驗,不是真正的資安級廣告阻擋器;它可能漏掉廣告或誤刪一般內容,也不處理追蹤器、惡意程式與影片廣告。若要正式使用,仍應採用成熟的阻擋工具。
案例二:穿衣決定,讓 Jev 從「今天可穿的組合」中選擇
穿衣決定是很典型的 System One 設計模式:答案不是生成一段時尚文案,而是從衣櫃中選出一套可執行的搭配。程式先取得所在地天氣、降雨機率、行程場合、洗衣狀態與使用者實際擁有的衣物,再把合法組合列成 Choice;Jev 可同時判斷保暖程度、正式程度、顏色協調與使用者偏好,最後由程式排除不耐雨、還在洗或不符合 dress code 的選項。
如果衣物資料只有照片,應先由視覺模型或人工把材質、顏色與類型轉成文字欄位,因為 Jev 目前只接受文字或 JSON,不直接看圖片。溫度換算、是否下雨與衣物可用狀態也應由程式精確計算;低信心時則顯示兩三套候選讓使用者挑選,而不是自動下單。
查證說明:截至 2026 年 9 月 20 日,我們在公開的 Jev 專案目錄與 GitHub 專案中沒有找到可驗證的「穿衣決定」成品,因此這一段是可實作的應用設計,不冒充已上線案例,也不放無關圖片。
案例三:投資與交易,把市場判斷限制在可稽核的選項裡
Jev Trader 是一個 MIT 授權的實驗專案。它讀取 Monad 上 Kuru 的 MON-USDC order book,要求 Jev 在每個約 300 ms 的區塊回答 buy 或 sell,再由程式決定掛單價格、數量、撤單、部位上限與交易狀態。沒有設定私鑰時,專案預設以真實 order book 加模擬成交的 dry-run 模式執行。
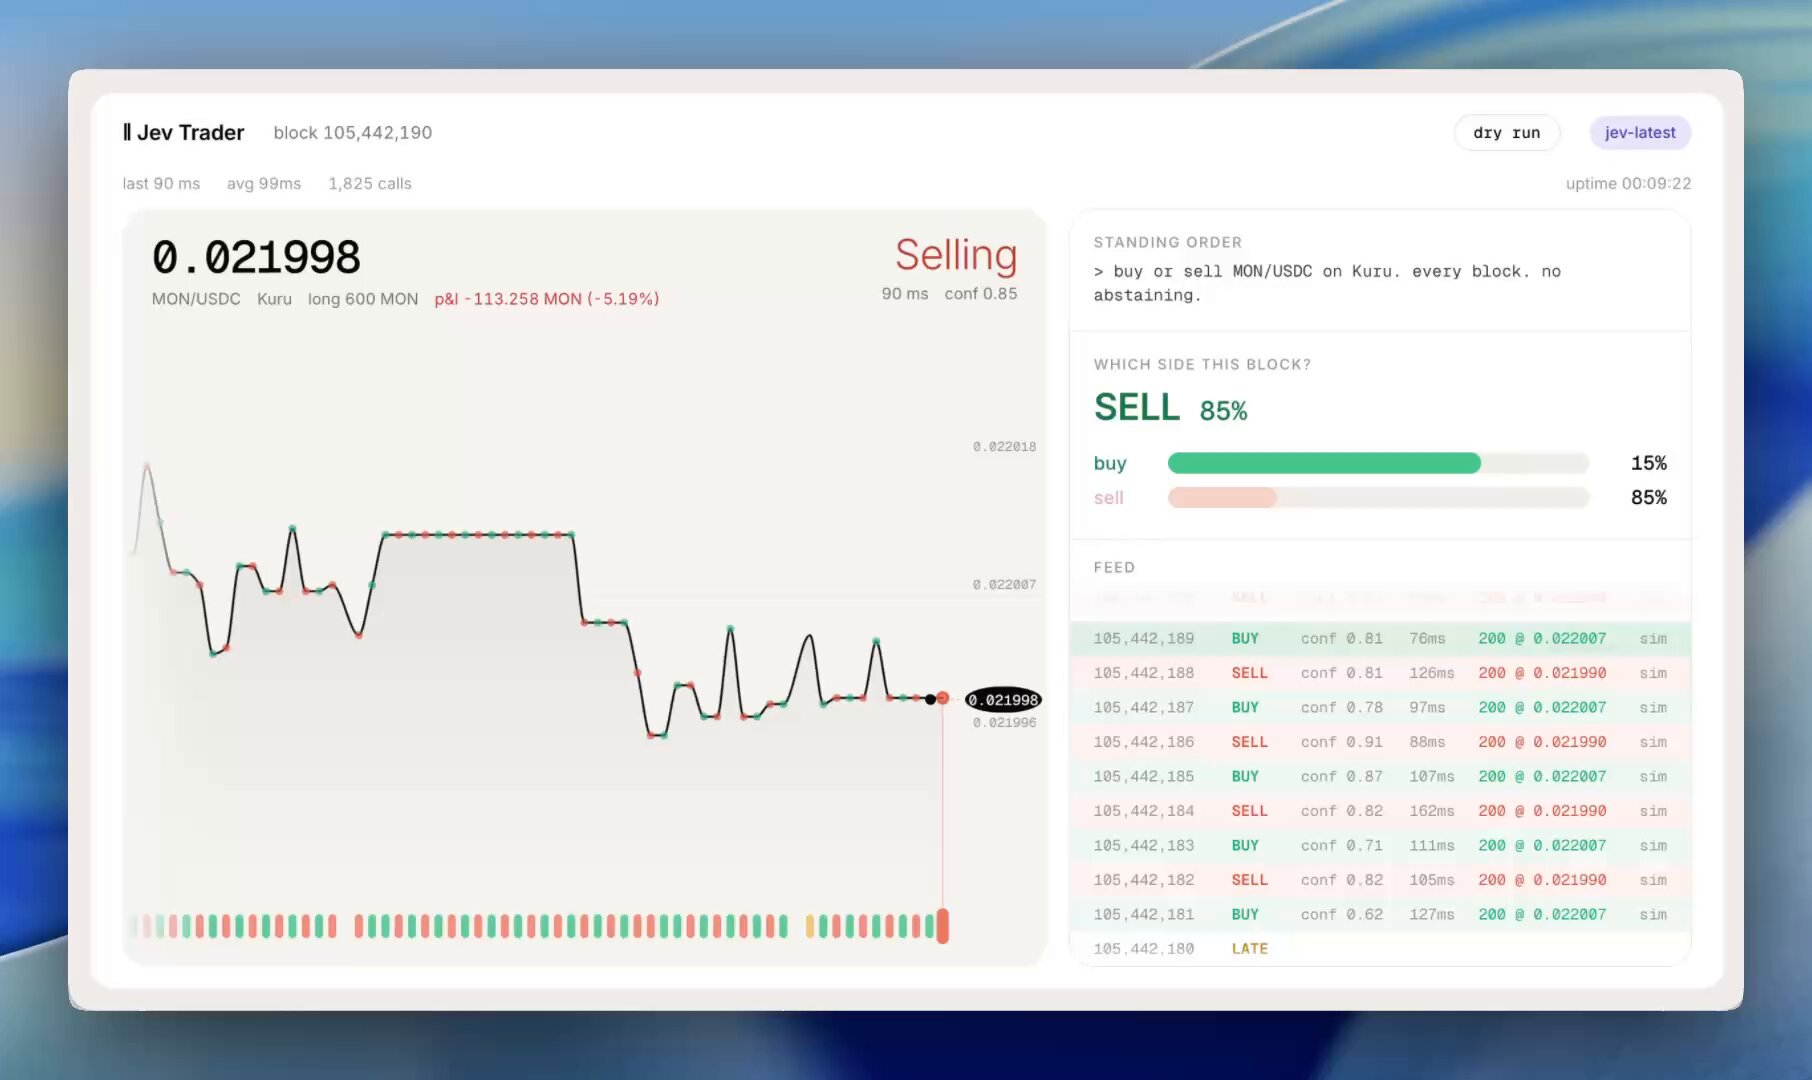
圖:Jarrod Watts 的 Jev Trader 原始示範;畫面右上角標示 dry run。數字為作者案例,不代表投資績效。
這不是讓 Jev 自由發揮的投資顧問。價格計算、風險限制、資金權限與是否真的送單,都必須留在可測試的程式碼與人工控制中。對正式投資研究,更保守的模式是只讓 Jev 對財報、事件與央行聲明做 Choice、Score、Noul 分類,產生可稽核的觀察清單,再由人決定是否採用;開源專案 SmartMoney-Cub 就採唯讀 journal 與人工 promote/reject 的方向。任何這類 demo 都不構成投資建議,也沒有證明能穩定獲利。
案例四:加速瀏覽器 agent,不是讓 Chrome 渲染更快
Jev Ultrafast 把瀏覽器 agent 每一步的「下一個動作與目標元素」改成一次 Jev 請求。頁面先被整理成帶編號的可操作元素表,Jev 從 CLICK、TYPE_TEXT、SELECT、SCROLL、WAIT、DONE 等封閉動作中選擇;只有真的需要輸入文字時,才呼叫小型生成模型。
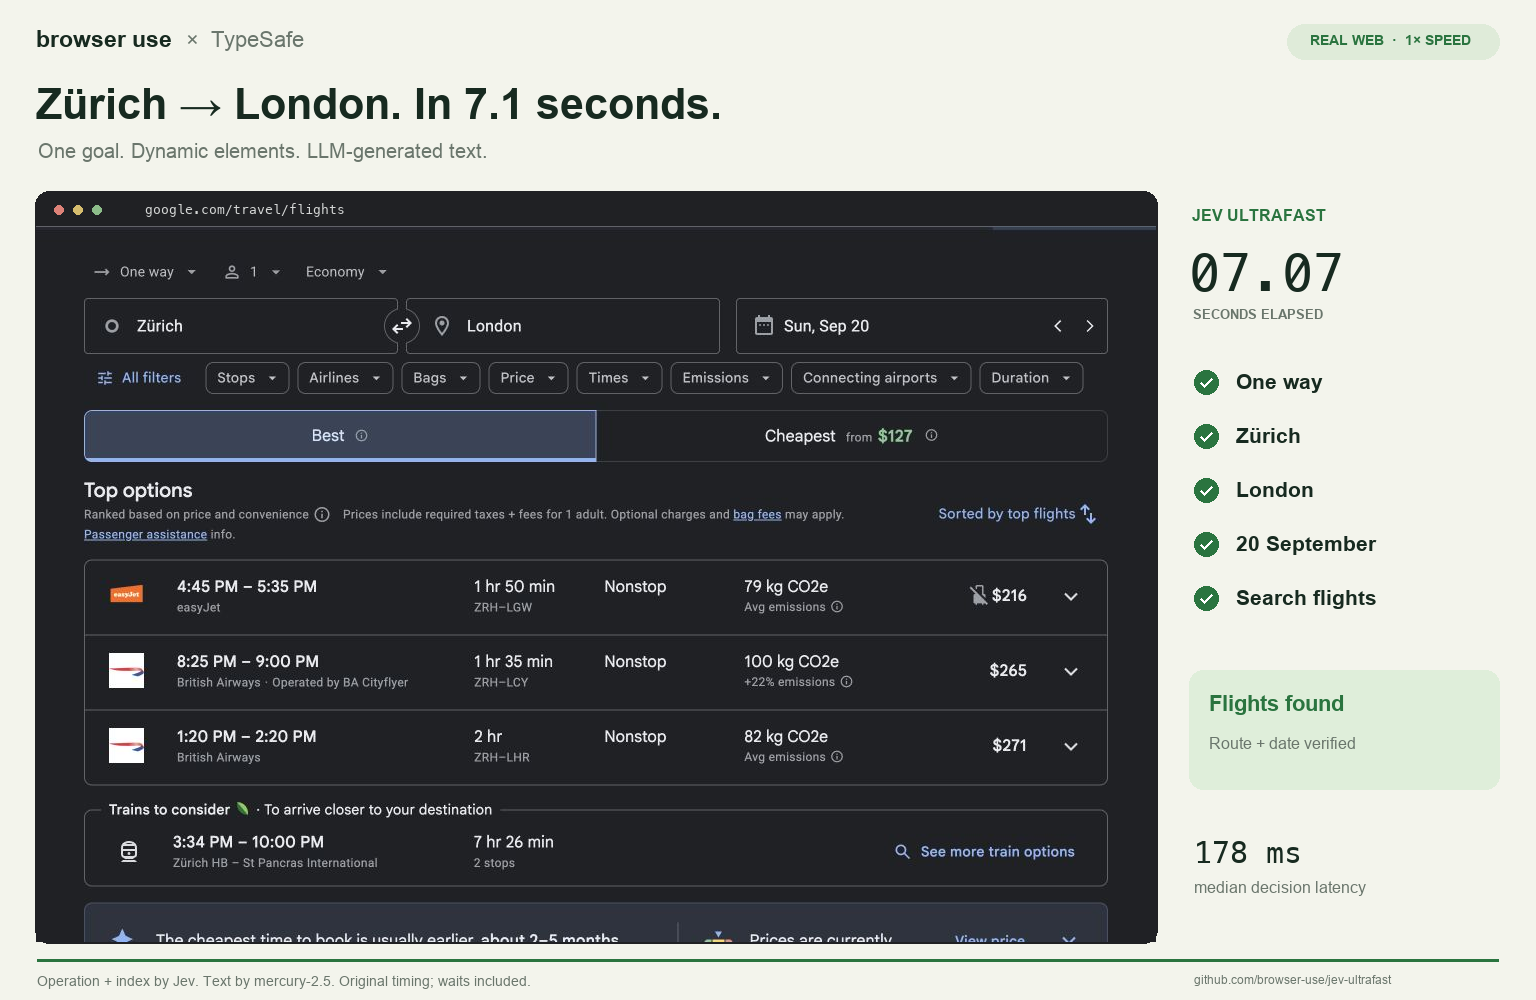
圖:Browser Use Jev Ultrafast repo 原始結果圖。7.1 秒與 178 ms 是該次作者示範的量測,不是所有網站的通用 benchmark。
所以這裡的「加速瀏覽器」不是修改 Chrome 的 JavaScript 引擎或網路下載速度,而是縮短 agent 看頁面、決定下一步、再操作的迴圈。專案預設不用截圖做決策,而是讀取結構化 DOM 狀態;執行前也會再次檢查元素是否仍存在、是否被遮住,以及頁面是否已過期,避免把模型輸出直接當成 selector、座標或可執行程式碼。
還有哪些已出現的應用?
除了上述四種方向,Awesome Jev 收錄的公開專案還涵蓋:
- 閱讀與瀏覽整理:Unclutter 判斷頁面哪些元素不是主要內容,並把規則留在本機供下次使用;jev-skip 則從 YouTube 字幕為各段落標示業配機率。
- 搜尋與資料整理:對每個函式做語意搜尋、在 Neo4j 圖上選下一條關係、替論文分類,或對大量 JSONL/Parquet 記錄做篩選。
- 程式碼與 agent 品質:檢查 staged diff、判斷 agent 是否已完成工作、偵測敏感資訊、替 log 排優先順序,或在 agent 卡住時選擇繼續、重規劃與停止。
- 模型與工具路由:依每一輪任務難度選模型、thinking depth 或 agent skill,低信心時拒絕硬猜。
- 企業流程:履歷初篩、email intent 分流、客服案件分類、內容審核、引用支持度、智慧家庭 sensor 與自動化。
- 即時互動:Doom、Mario、Tetris、無人機與機械手臂,讓程式掌握物理與安全邊界,Jev 只在分支點做戰術判斷。
反過來說,若任務需要撰寫文章、產生程式碼、自由回答、精確計數、日期運算或多層推理,就不是 Jev 的主場。TypeSafe 在 Jev 1.13 的限制說明中也列出幾個已知弱點:模型可能過度照字面理解、不能可靠計數、不擅長數學與日期比較、多層間接推理會降低準確率,大量無關內容也會造成 context rot。能用程式精確計算的部分,應該留在程式裡。
Jev 是 open source 嗎?要分模型、SDK 與替代實作來看
談 Jev 的 open source 生態時,最容易把三個不同層次混在一起。
1. Jev 模型本身
截至本文撰寫時,Jev 1.13 是透過 TypeSafe 的託管 API 使用,官方文件列出的端點是 POST /v1/systemone。官方公開了模型價格、context、輸入格式與已知限制,但沒有公開 Jev 1.13 的模型權重與訓練資料。因此它不是可以自行下載權重、部署在內網的 open-weight 模型。根據 官方 model 頁面,Jev 1.13 的輸入價格為每百萬 token 0.042 美元,輸出不計費,目前只接受文字、JSON 物件或文字陣列。
2. 官方 SDK 與 adapter
TypeSafe 的 Python SDK、JavaScript/TypeScript SDK,以及把一般 LLM 包成相同介面的 System One Adapter 都是 MIT 授權的公開原始碼。不過 SDK 開源不等於它背後呼叫的 Jev 權重也開源。
3. 社群的可自建模型與相容實作
Jev 發布後,很快出現了幾種不同路線的公開實作:
- SemIf:從凍結的開放模型讀取選項機率,採 MIT 授權。
- Laya:以 encoder 為基礎的決策模型系列,提供可自行部署的權重與 Apache 2.0 授權,包含多語 322M 模型。
- djev-spark:在 DGX Spark 上以 DiffusionGemma 提供 Jev 相容 API 的公開實作。該 repo 目前未標示 license,評估商業或再散布用途前應先確認授權。
- system-one:示範如何把一般開放 LLM 轉成單次 forward pass 的選項分類器。
自建的優勢是資料不必送到外部 API、可固定版本,也能針對自己的資料微調;代價則是 GPU、維運、校準與評測都由自己承擔。更重要的是,這些實作雖然介面相似,底層架構、語言能力、選項上限、context 與信心定義都不同,不能因為都回傳 Choice、Score、Noul 就視為可直接互換。
我們怎麼測:把五套系統放進多輪 RAG 路由
為了回答「託管的 Jev 和可自建模型是否真的能互相替換」,我們建立了 公開的 Jev Benchmark。測試場景是一個企業內部 RAG 助理,面前有六個知識庫、八份指定文件與六種工具。評測不看最後生成的答案,而是看回答之前的路由決策。
資料包含 20 段對話,每段 5 輪,共 100 個多輪決策。每一輪,系統必須同時做對四件事:
- route:答案要從對話、一般知識、指定文件、知識庫、公開網路或工具取得,還是應追問或拒絕。
- scope change:話題是否切換、擴大、縮小、衝突或被擋下。
- mode:應該回答、改寫、分析、追問或擋下。
- restriction:下一輪是否仍限定指定文件,或禁止使用公開網路。
表格中的「決策正確」採嚴格定義,四項必須在同一輪全部答對才算正確。
| 系統 | 決策正確 | route | scope change | mode | restriction | p50 | p95 |
|---|---|---|---|---|---|---|---|
| Gemma 4 31B(自建) | 77.0% | 90.0% | 87.0% | 92.0% | 95.0% | 2,293 ms | 4,723 ms |
| Jev 1.13.0(託管 API) | 61.4% | 90.6% | 85.8% | 91.6% | 84.4% | 749 ms | 818 ms |
| djev-spark(自建) | 32.2% | 69.2% | 51.0% | 80.2% | 90.4% | 1,230 ms | 1,470 ms |
| SemIf(自建) | 24.0% | 62.0% | 49.0% | 65.0% | 91.0% | 627 ms | 1,206 ms |
| Laya 322M(自建) | 0.0% | 18.0% | 25.0% | 10.0% | 36.0% | 189 ms | 312 ms |
Benchmark 告訴我們什麼
Jev 的優勢不是每一項都最高,而是延遲穩定
Jev 在「去哪裡找」與「話題是否改變」兩項,和 Gemma 4 31B 很接近;主要差距出現在會跨輪延續的 restriction。Jev 的 p50 是 749 ms,p95 是 818 ms,慢尾只比一般回應稍慢。Gemma 的 p50 是 2,293 ms,p95 則超過 4.7 秒。若產品承諾的是穩定的反應時間,p95 往往比平均速度更有意義。
開源、可自建與可替換是三件不同的事
djev-spark、SemIf 與 Laya 都能提供類似的結構化決策介面,也能把資料留在自己的環境,但在這個零樣本、多輪、中文與英文混合的 RAG 路由任務上,正確率差異很大。Laya 322M 雖然最快,卻沒有任何一輪同時答對四項;這不代表它在所有任務都無效,而是代表未經針對這個任務微調的基礎模型,不能只看 latency 就直接上線。
路由模型不能是高風險工具前的唯一防線
當題目真的缺少必要資訊時,Gemma 只有 43% 會正確追問,Jev 是 31%。兩者常見的錯誤都是不追問,直接選擇呼叫工具。如果工具會寄信、開工單、付款或改動正式資料,就必須再加上明確的權限檢查、參數驗證、使用者確認與可逆性設計。信心高不等於已獲授權。
先確認模型真的讀到了輸入,再相信低分
測試過程中,我們曾因中文被錯誤跳脫、輸入長度膨脹,以及 SSH tunnel 中斷而得到嚴重失真的結果。最極端的案例從 3.8% 修正為 32.2%。因此 benchmark 不只公開總分,也公開問題定義、逐筆預測、計時紀錄、標準答案稽核與測試方法。低分可能是模型能力問題,也可能是 adapter、序列化、連線或計分流程出了錯。
導入 Jev 或開源替代方案前,先回答五個問題
- 答案空間是否真的封閉?若事前無法列出合法答案,就應考慮生成式模型或先做候選產生。
- 錯一次的代價是什麼?讀錯頁面和誤寄郵件需要完全不同的 confidence threshold 與確認流程。
- 資料能不能送到託管 API?若涉及內部機密、個資或資料落地要求,應先完成資料分類與法遵評估,必要時選擇自建方案。
- 有沒有自己的測試集?官方或第三方總分不能取代中文、領域術語、真實選項與實際錯誤成本下的驗證。
- 狀態由誰維護?多輪應用最容易失敗的往往不是單題分類,而是上一輪的限制、權限與範圍沒有被正確保存。
最穩健的導入方式,是先挑一個高頻但可逆的路由或分類任務,保留既有流程作為 shadow mode,記錄模型版本、完整機率、實際結果與人工覆核,再依真實資料調整門檻。若切換到新模型版本,也要重新跑同一套回歸測試。
結語:讓模型做判斷,讓程式掌握控制權
Jev 最值得注意的地方,不只是速度或價格,而是它重新劃分了 AI 與軟體的責任。模型負責理解語意並產生有限範圍的判斷;程式負責狀態、權限、門檻、數學與副作用;生成式模型只在真的需要文字與推理時出場。
System One 模型不會讓錯誤消失,但它把錯誤變成更容易量測、記錄與治理的形式。這也是為什麼選型不能只看一個漂亮的 latency 數字或單題 demo,而要把模型放進真正的多輪流程,觀察限制如何延續、低信心時會不會停下來,以及錯誤是否會觸發不可逆的動作。
完整題目、程式、逐筆結果、圖表與測試限制,都已公開在 Jev Benchmark GitHub repository。如果你正在設計企業 RAG、agent router 或模型 guardrail,可以直接用這套資料重跑,也歡迎提交新的 adapter 與結果,讓不同 System One 實作能在同一個可重現的基準上比較。