AIはどのようにフェイクニュースを検出するのか?5つの手法とその限界
AIによるフェイクニュースの検知は、記事を読んで真偽を断定するのではなく、コンテンツ、情報源、拡散、アカウント、画像から異常なシグナルを見つけ、人手による検証の範囲を絞り込むものです。本記事では、五つの手法の原理と限界、および検証ワークフローへのつなぎ方を整理します。
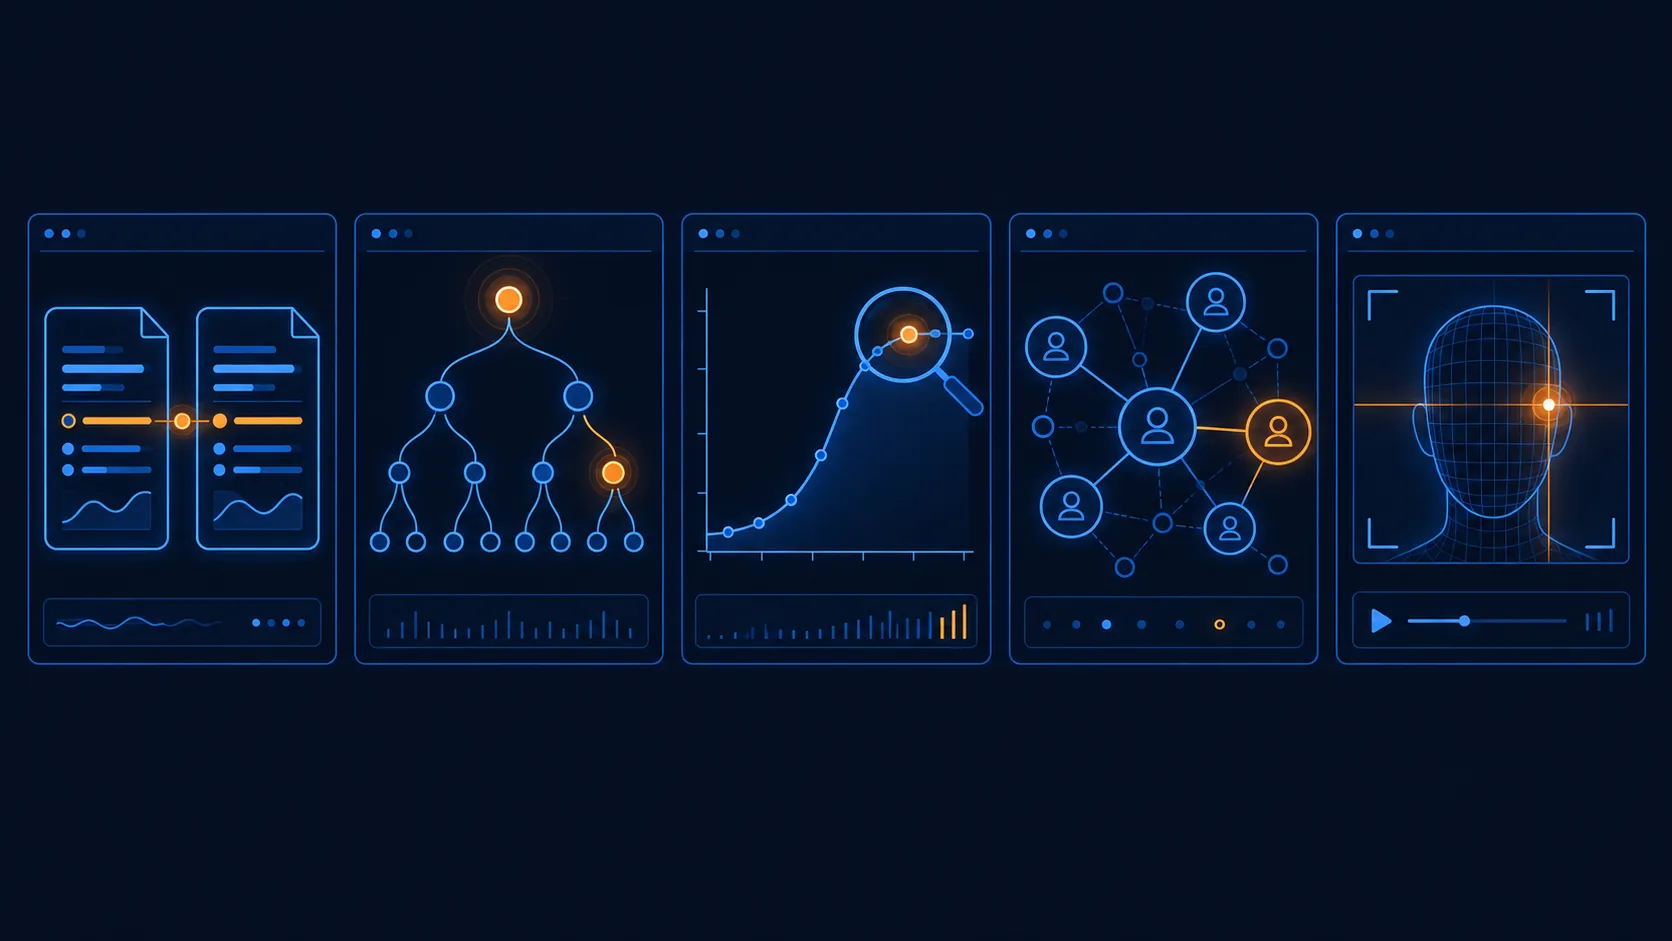
クイックアンサー:AIはどのようにフェイクニュースを検知するのか
AIは、本記事で整理した五種類のシグナル、すなわち主張の照合、情報源の信頼性と発信源の追跡、拡散パターン、アカウントの協調的な行動、画像・映像のマルチモーダル分析からフェイクニュースを検知できます。検証の範囲を絞り込み、異常を早期に見つける助けにはなりますが、単独で真偽を判定することはできません。システムが出力するのは疑わしいシグナルと調査の手がかりであり、真偽の認定、帰属の判断、対応の決定は人手による検証が行います。
まず整理しておくこと:「検知」と「ファクトチェック」は別のものです
ツールを評価する前に、検知とファクトチェックを区別する必要があります。検知は「どのコンテンツを優先的に確認すべきか」に答えるもので、絞り込みと優先順位付けにあたり、大規模な自動化が可能です。ファクトチェックは「この主張は事実か」に答えるもので、一次資料を探し、公式記録と照合し、結論に責任を持つ必要があります。
スクリーニングのラベルをファクトチェックの結論として扱うと、証拠やモデルの限界を見落とすおそれがあります。システムは抽出した理由を説明し、そのうえでファクトチェックの担当者が判断します。さらにもう一段の区別が必要です。真偽は担当者が証拠に基づいて判断し、違法かどうかは権限のある機関が法に基づいて認定します。虚偽と判断されたことは、違法を意味しません。
「フェイクニュース」という用語自体にも限界があります。WardleとDerakhshanが2017年に欧州評議会(Council of Europe)向けに執筆した報告書『Information Disorder』は、情報の無秩序を誤情報、偽情報、悪意ある情報の三つに分類し、「fake news」という用語ではこれらの現象を十分に説明できないと主張しています。注意すべきコンテンツは捏造されたものとは限らず、たとえば本物の写真に誤った時間や場所が添えられている場合もあります。
五つの検知手法:原理、適用範囲、限界
五つの手法はそれぞれ異なる層のシグナルを見ており、実務では組み合わせて使えます。以下では同じ形式で、原理、捉えやすいもの、起こりうる誤判定、必要なデータを説明します。
一、主張の照合(claim matching)
原理:検査対象のコンテンツを、数字、政策、発言の引用など、検証可能な主張に分解し、意味的な類似度を用いて、ファクトチェック済みの主張のデータベースと照合します。重視するのは文字列ではなく意味です。同じ主張が、書き換えられたり、見出しを変えられたり、翻訳されたり、画像カードに作り替えられたりして、再び拡散することがあるためです。
捉えやすいもの:再び拡散する古い主張とその変種です。たとえば、台風、感染症、選挙の期間に再び現れる既存の流言や、体裁を変えたファクトチェック済みのコンテンツがあります。台湾ファクトチェックセンター、MyGoPenなどのファクトチェック団体の公開結果や、クラウドソーシング型のファクトチェックプラットフォームであるCofactsは、照合の参考にできます。利用の際は、ライセンスとコンテンツの品質を確認してください。
起こりうる誤判定:流言を引用したうえで釈明する報道は、類似度が高いために誤ってラベル付けされることがあります。主張の場所や数字を変えると、類似度が閾値を下回ることもあります。根本的な限界は、対応するファクトチェックの記録がない場合、既存のチェック結果を直接提示できないことです。
必要なデータ:継続的に更新されるファクトチェック済みの主張のデータベース、繁体字中国語の口語的な言い換えを処理できる意味モデル、画像カード内の文字を含む完全なコンテンツです。
二、情報源の信頼性と発信源の追跡
原理:一方では、サイトの開設時期、誤った内容を繰り返し発信していないか、著者や連絡先を確認できるかなど、発信者の実績を評価します。もう一方では、転載や引用をさかのぼり、その主張が現在観測可能なデータの中で最初に現れた時期と場所、およびその間にどのような書き換えを経たかを特定します。
捉えやすいもの:ニュースサイトを装うコンテンツファーム、正規の機関の名義を無断で使ったメッセージ、出所が不明なのに大量に転送されるスクリーンショットです。
起こりうる誤判定:過去の実績に過度に依存すると、新しく設立された正当なメディアを過小評価したり、評判の良い情報源の偶発的な誤りを見逃したりするおそれがあります。発信源の追跡はデータの網羅範囲に制約されます。見ることのできないクローズドなグループや削除された投稿があると、観測できる最古のバージョンを発信源と取り違えることがあります。
必要なデータ:タイムスタンプ付きのプラットフォーム横断の履歴データ、情報源の属性の記録、転載と引用の関係です。追跡の品質は、データの網羅範囲、タイムスタンプ、関連記録が完全かどうかによって決まります。
三、拡散パターン
原理:メッセージが時間とプラットフォームをまたいで広がる形を観察します。ボリュームが短時間で急上昇する、複数のプラットフォームでほぼ同時に同じナラティブが現れる、閑散とした時間帯に活動が集中するといった現象を調査すべきシグナルとして挙げ、自然な事象、予約投稿、話題のベースラインと照らし合わせます。
捉えやすいもの:異常なボリューム、プラットフォーム間のリレー(たとえば、まずフォーラムに現れ、その後ショート動画やメッセージンググループで拡散する)、ボリュームの伸びが話題のベースラインと明らかに合わない話題です。
起こりうる誤判定:突発的な事象、著名人による転載、メディア報道もボリュームの急上昇を引き起こします。異常なボリュームは確認する価値があることを示すだけで、誰かが操作していることを意味しません。同時期のニュースと照らし合わせて判断する必要があります。
必要なデータ:複数のプラットフォームの時系列データ、話題とナラティブの分類、ベースラインを確立できるだけの履歴データです。
四、アカウントの協調的な行動
原理:アカウント群の間の関係を見ます。投稿が高度に同期しているか、内容が大量に重複しているか、わずかに書き換えられているだけか、互いに頻繁に転載しているか、アカウントの作成時期や活動履歴が不自然に集中していないかといった点です。Metaは2020年のCIBレポートで、協調的な不正行為(CIB)を、戦略的な目的のために公の議論を協調して操作する行為で、偽アカウントがその運用の中核にあるものと定義しました。措置の根拠は、コンテンツそのものではなく、行動の欺瞞性です。これがこの種の手法の出発点でもあります。
捉えやすいもの:協調的な世論誘導、複数のアカウントによる偽の合意の演出、同じアカウント群が話題をまたいで順番に動員される行為です。内容の真偽に依存しないため、真実の情報を選択的に増幅する操作も見つけられます。
起こりうる誤判定:実際のコミュニティの動員、ファンによる応援、正当な提唱活動も、高度に同期することがあり、予約投稿ツールを使う組織にも似た特徴が見られます。協調性のシグナルは確率的な分析であり、状況に応じた閾値の調整と、人手によるアカウントサンプルの確認が必要で、違法性の認定にはあたりません。
必要なデータ:アカウントの公開フィールドと活動記録、インタラクションの関係データ、十分に長い行動履歴です。プラットフォームごとに公開されるフィールドが異なるため、分析の深さも異なります。
協調的な行動の検知が全体のモニタリングフローの中でどのような位置にあるかについては、フェイクニュース検知・認知戦モニタリングシステムの説明をご覧ください。
五、マルチモーダル分析:画像、動画、ディープフェイク
原理:偽情報は、画像カード、スクリーンショット、ショート動画の形をとることもあります。マルチモーダル分析では、光学文字認識(OCR)で画像内の文字を抽出して画像カードを主張の照合の対象にし、画像認識で古い画像の再利用やコラージュによる改変を調べます。動画とディープフェイクの検知では、顔、音声、映像の不整合を調べます。
捉えやすいもの:偽造された公文書やニュースのスクリーンショット、本来の文脈から切り離された古い写真、公的な人物の姿や声を無断で使った合成映像・音声、テキスト検索では見つからない画像のみのコンテンツです。
起こりうる誤判定:圧縮、トランスコード、フィルターは、モデルが依拠する特徴を変える可能性があります。風刺や二次創作は合成コンテンツですが、必ずしも欺く意図があるとは限りません。検知モデルは、学習時に見ていない生成方式やデータ分布に遭遇すると性能が低下する可能性があるため、拡散の経緯や当事者への確認と併せて用いる必要があります。
必要なデータ:入手できる最高画質のバージョン、拡散の経緯、継続的に更新される合成サンプルです。
五つの手法の比較一覧
| 手法 | 見るシグナル | 強み | 限界 | 主要なデータ |
|---|---|---|---|---|
| 主張の照合 | コンテンツ内の検証可能な主張 | 古い流言とその変種をすばやく識別できる | ファクトチェックの記録がないと結論を示せない | ファクトチェック済みの主張のデータベース |
| 情報源と発信源の追跡 | 発信者の実績と転載経路 | なりすましの情報源とコンテンツファームを検出する | クローズドなグループや削除された投稿は見えない | プラットフォーム横断の履歴データ |
| 拡散パターン | ボリューム曲線とプラットフォーム横断の時系列 | 異常な拡散を早期に検出 | 実際に話題となっている出来事との区別が必要 | 時系列と過去のベースライン |
| アカウントの協調的行動 | 投稿のリズム、類似度、インタラクションネットワーク | 内容の真偽には依存しない | 本物のコミュニティ動員と混同するおそれがある | アカウントの公開項目とインタラクションデータ |
| マルチモーダル分析 | 画像内の文字、映像・音声の特徴 | テキスト検索では見えない内容を対象にできる | 圧縮や、未知の生成方式の影響を受ける | 高画質のファイルと拡散の経緯 |
単一の手法にはそれぞれ死角があります。協調的な行動の分析やマルチモーダル分析は、内容照合では見えない側面を補えますが、調整と人手による検証も必要です。本記事の運用上の提案は、異なるシグナルを組み合わせてレビューの順序を決めることです。優先度は、シグナルの質、シグナル同士が互いに独立しているか、事象に想定される影響をもとに設定し、単に該当した項目の数を数えるのではありません。
生成AIがもたらす変化:文字列の照合から、ナラティブと行動の分析へ
生成AIにより、似ていながら同一ではない文章を簡単に作れるようになりました。文字列の重複に頼った照合は、これまでコピー&ペーストによる協調的な拡散を捉えられましたが、各アカウントが語調や用語の異なる書き換えを入手できるようになると、この種の照合は効果を失う可能性があります。
対応策は、内容分析をやめることではなく、観察の範囲を広げることです。照合をナラティブのレベルに拡張し、異なる言い回しが同じ結論に向かっていないかを確認します。あわせて、アカウントの活動履歴、投稿の同期性、インタラクションのネットワーク、プラットフォーム間での出現順序といった時系列データも調べます。これらのシグナルも意図的に仕組まれる可能性があるため、有効性は自社のデータで検証する必要があります。
もう一つの誤解は、「この文章はAIが書いたものか」を検知の目標にしてしまうことです。正当な利用者も生成ツールを使って文章を書いており、生成された文章が再度書き換えられると、AI文章検出の識別性能も低下する可能性があります。偽情報の検証では、主張が信頼できるか、誰がどのような方法で拡散しているかを問うべきです。
合成された映像・音声の作成のハードルが下がっているため、マルチモーダルの確認は日常的な業務フローに組み込めます。入手できる最高画質のバージョンとそのURL、取得日時をできるだけ早く保存し、オリジナルのファイルかどうかを明記します。
精度の数値が必ずしも比較できない理由
各社が示す精度がいずれも実測値であっても、評価条件が異なるために直接比較できないことがあります。下の表に、確認すべき四つの評価条件と、ベンダーに直接尋ねられる質問をまとめました。
| 評価条件 | 数値に影響する理由 | 確認すべき質問 |
|---|---|---|
| データセット | プラットフォーム、期間、言語、題材によって課題の難易度は変わります。英語のニュース見出しでの成績は、繁体字中国語のフォーラム投稿や画像カードでの性能を示すものではありません。 | テストデータはどのプラットフォームと言語のものですか。貴機関が関心を持つ題材は含まれていますか。 |
| ラベリング基準 | 部分的な誤り、誇張、風刺、文脈を切り取った引用をフェイクニュースに含めるかどうかは、データセットごとに定義が異なる場合があります。アノテーター間の意見の相違も、正解データの信頼性や評価の解釈に影響します。 | ラベリング基準は何ですか。誰がラベルを付けましたか。複数のアノテーターの意見が分かれた場合はどう処理しますか。 |
| 陽性・陰性サンプルの比率 | 実際の不審なコンテンツの割合が低い場合、陽性と陰性が半々のテストセットでモデルが良好な成績を示していても、警報に含まれる誤報の割合は高くなることがあります。そのため、正解率だけでなく、適合率と再現率も確認してください。 | テストセットの陽性・陰性の比率はどのくらいですか。実際の比率に近い条件での適合率と再現率を提示できますか。 |
| 時間によるドリフト | 話題、用語、手口は変化します。学習データと同じ時期のテストでは将来の期間での性能を反映できない可能性があるため、期間をまたいだ評価を別途実施すべきです。 | テストデータは学習データより新しいものですか。モデルはどのくらいの頻度で更新され、性能の低下はどのように監視していますか。 |
本記事では、公開ベンチマークに加えて、自組織のシナリオでのバックテストを行うことを推奨します。既知の複数の事案と平常期間を対象に、事案が拡大する前にシステムが警告できるか、平常期間にどれだけ誤報が出るかを確認します。
検証ワークフローの構築:警報から対外コミュニケーションまで
本記事では、検知結果を検証プロセスにつなげることを推奨します。以下の四つのステップは、本記事が推奨する基本構成です。レビュー担当者と対応期限が決まっていないと、警報が適時に処理されない可能性があります。
| ステップ | 何をするか | 設計の要点 |
|---|---|---|
| 警報の段階設定 | 検証可能な主張、複数のシグナルが同時に成立しているか、拡散の速さ、具体的な影響範囲に基づいて段階を設定します | 段階の基準は文書化して、説明と調整ができるようにします。政治的立場をリスクの判断基準にしません。高い段階の警報には明確な対応期限を設けます |
| 人手によるレビュー | アナリストがシステムの示す理由とサンプルを確認し、正式な検証に進むかどうかを判断します | AIによる分析と人による判断は別の欄に記録し、システムのラベルがそのまま結論にならないようにします |
| 検証記録の保存 | スクリーンショット、元のリンク、取得日時、関連アカウントの情報を保存します | コンテンツは削除や改変される可能性があるため、必要な記録は早めに保存します。法的手続に関わる場合は、保存と鑑識の方法を別途確認します |
| 対外コミュニケーション | 検証結果に基づき、釈明を出すかどうか、誰が発言するか、どのチャネルで発表するかを決めます | 釈明の際は、元の流言をあらためて拡散させないようにします。必要に応じて、ファクトチェック団体やプラットフォームの通報窓口と連携します |
対外コミュニケーションはタイミングの見極めが重要です。対応が早すぎると、まだ小規模だった流言に注目を集めてしまうおそれがあり、遅すぎると誤った説明が先に議論を占めてしまうおそれがあります。拡散分析は、タイミングを判断する際の参考になります。
公的機関が導入する際は、まず境界を明確にする必要があります。公開情報源にも個人データが含まれる可能性があるため、収集・保存の範囲、目的、権限、期間は、適用される規範と機関の職務上の必要性に基づいて確認します。モニタリングの目的は検証と釈明であり、特定の発言者を狙うものではありません。システムのラベルも協調性のシグナルも、違法性の認定にはあたりません。
関連記事
よくある質問
フェイクニュースの検知と検証ワークフローの導入方法を検討されていますか
LargitDataは、モニタリングの範囲と既存の検証ワークフローの棚卸しを支援し、実現可能な導入方法をご説明します。
お問い合わせ